Wei Ji

K8s 不是一個完整解決方案,K8s 只是框架。

驚不驚喜?意不意外?

當你安裝了 Docker 之後就可以開始打包 image 並運行程式,甚至可以使用 Dokcer Compose 指令開始進行容器編排 (Orchestration)。

反觀,對於一個 K8s 使用者而言,生態系內有很多「口味」供你選擇:Minikube、MicroK8s、K3s、GKE、EKS...但是當你選擇原味 (Vanilla)時,你可能會發現歷經一番波折安裝完成之後,你還是什麼都不能幹:不能正常建立網路連線、不能正常的掛載持久化實體 (Volume)...

為什麼?因為 K8s 本身不是開箱即用解決方案,它只是一種框架。

不是開箱即用的網路​

info

這個段落會多次提及 OSI 的 L4 和 L7,對兩者差異不清楚的讀者建議先去查點資料,不然閱讀起來可能會有點吃力。

我在前一篇文章中介紹了 Service,以及內網模式 ClusterIP 與節點開埠 NodePort,即便是 NodePort 也不像是標準佈署使用的模式,因為它只能開奇怪的埠號。這是因為 Service 其實還有兩個生產環境在使用的模式:LoadBalancer 模式或是加掛一個 Ingress。

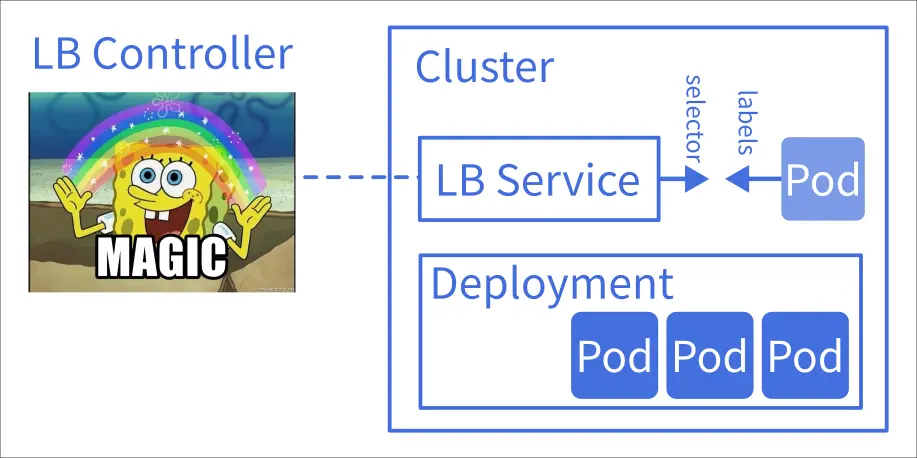
以 ServiceLB (LoadBalancer) 為例,K8s 只提供一個 L4 的抽象層,具體的實做依然需要別人來完成:

info

LB (LoadBalancer) Controller 是一個方便讀者理解的稱呼,實際情況比較複雜,有其他專門的術語用來稱呼這個東西。

在雲端環境(如 Google, AWS)這是由雲端供應商實作的,可能是一團閉源商業軟體和硬體級 LB 整合而成;在 K3s 中這是由 klipper-lb 透過 hostPort 實作的。

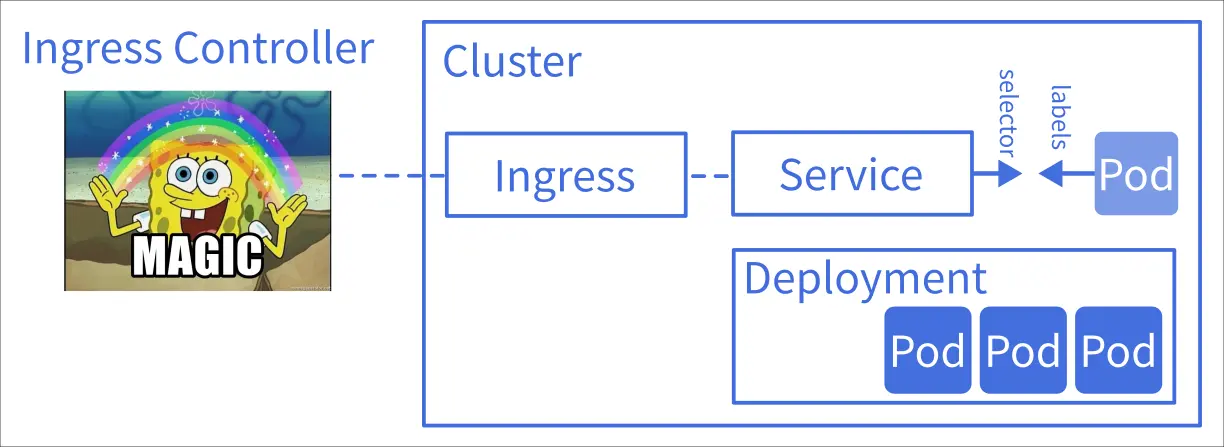
Ingress 也是相同的狀況,K8s 只提供一個 L7 的抽象層,具體的實做依然需要別人來完成:

實作可以是 Nginx 也可以是 Traefik。

不是開箱即用的持久化儲存​

K8s 在設計上就是一個分散式運行的框架,當 Pod 可能分散在多個不同的主機(節點)時,我們就不能像 Docker 那樣直接用某個路徑當作持久化實體。

在 K8s 的世界中,Volume 通常是一個 SDS (Software-defined storage); 在 K8s 的世界中,網路線就是 SATA 線。

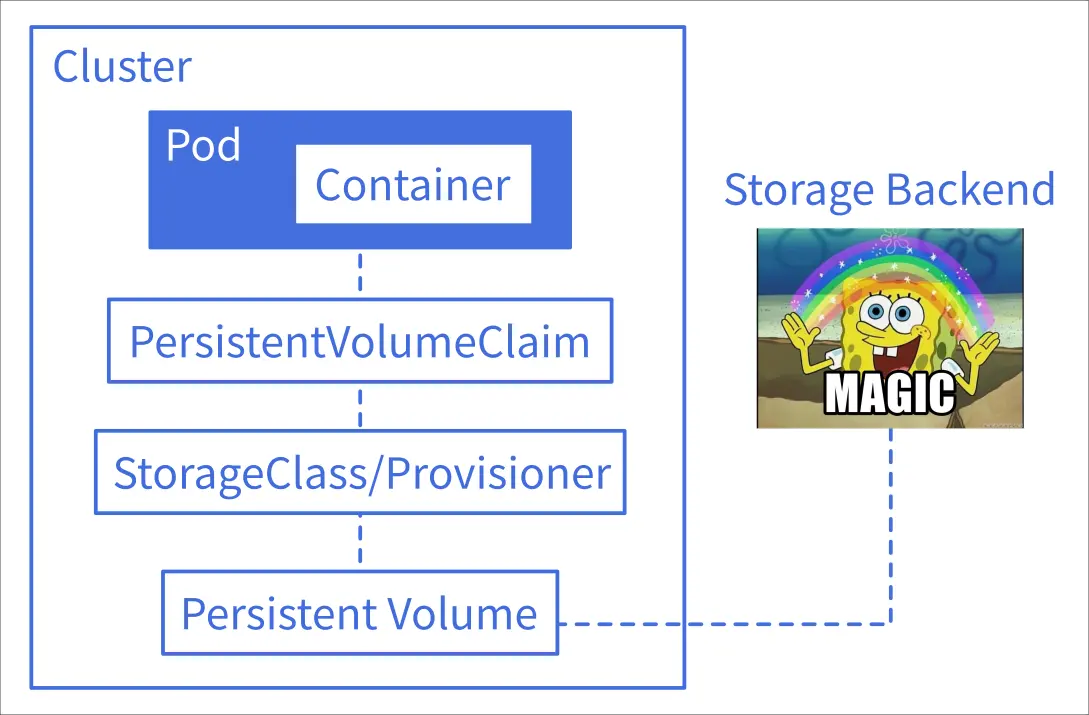
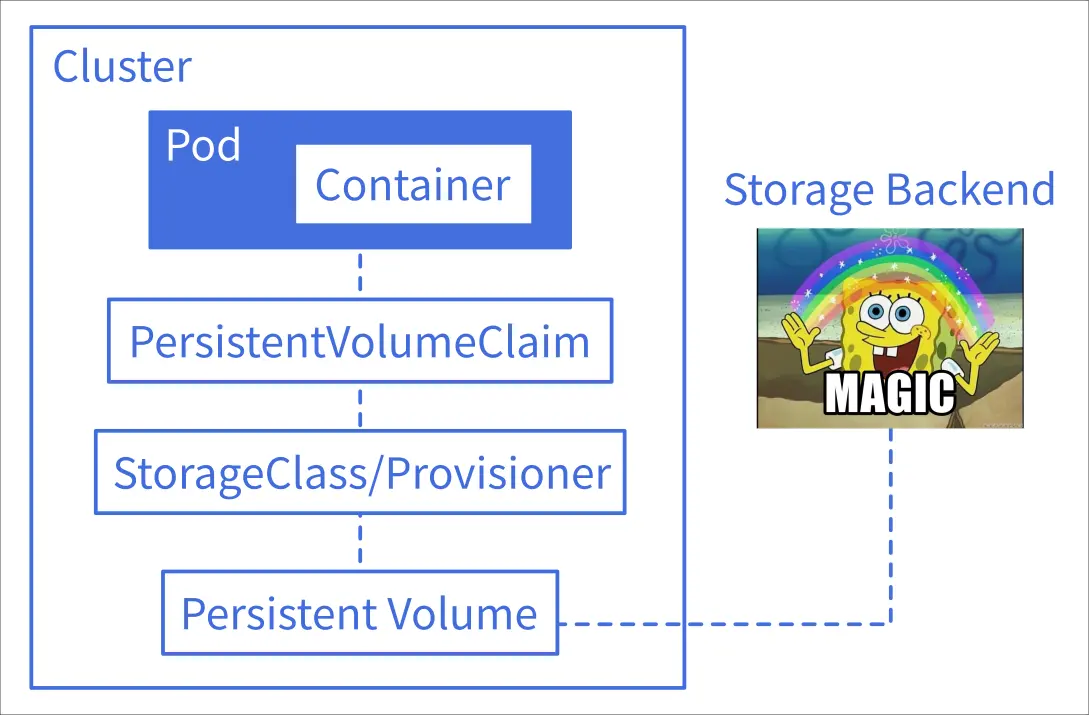
細節我不在此解釋,簡單來說在 K8s 要幫 Container 掛載 Volume 需要經過層層抽象,並且最後實際的儲存實體並不在 K8s 內實作:

info

你也可以在 K8s 設定 storageClassName: local-storage 的 Volume,但是這樣你可能需要額外配置讓 Pod 只能佈署在特定的 Node 上。

info

Storage Backend 同樣是一個方便讀者理解的稱呼,並不是 K8s 內的標準術語。

Wei Ji

Longhorn 可以用很多方式安裝,包含最基本的 kubectl 指令:

kubectl apply -f https://raw.githubusercontent.com/longhorn/longhorn/v1.10.1/deploy/longhorn.yaml

不過等等!不要急著下指令!讓我們瞄一眼裡面有些什麼:

wget https://raw.githubusercontent.com/longhorn/longhorn/v1.10.1/deploy/longhorn.yaml

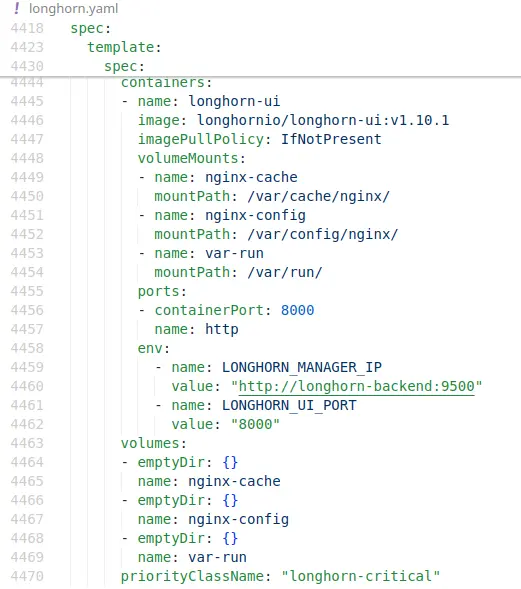
是的,這是一個有四千多行的 YAML,善於偷懶的聰明開發者們當然不會想直接跟這團東西打交道。

info

這個數字可以當作一個參考,一個完整的雲原生軟體佈署到 K8s 需要的聲明的資訊大概會達到這個量體。

Helm​

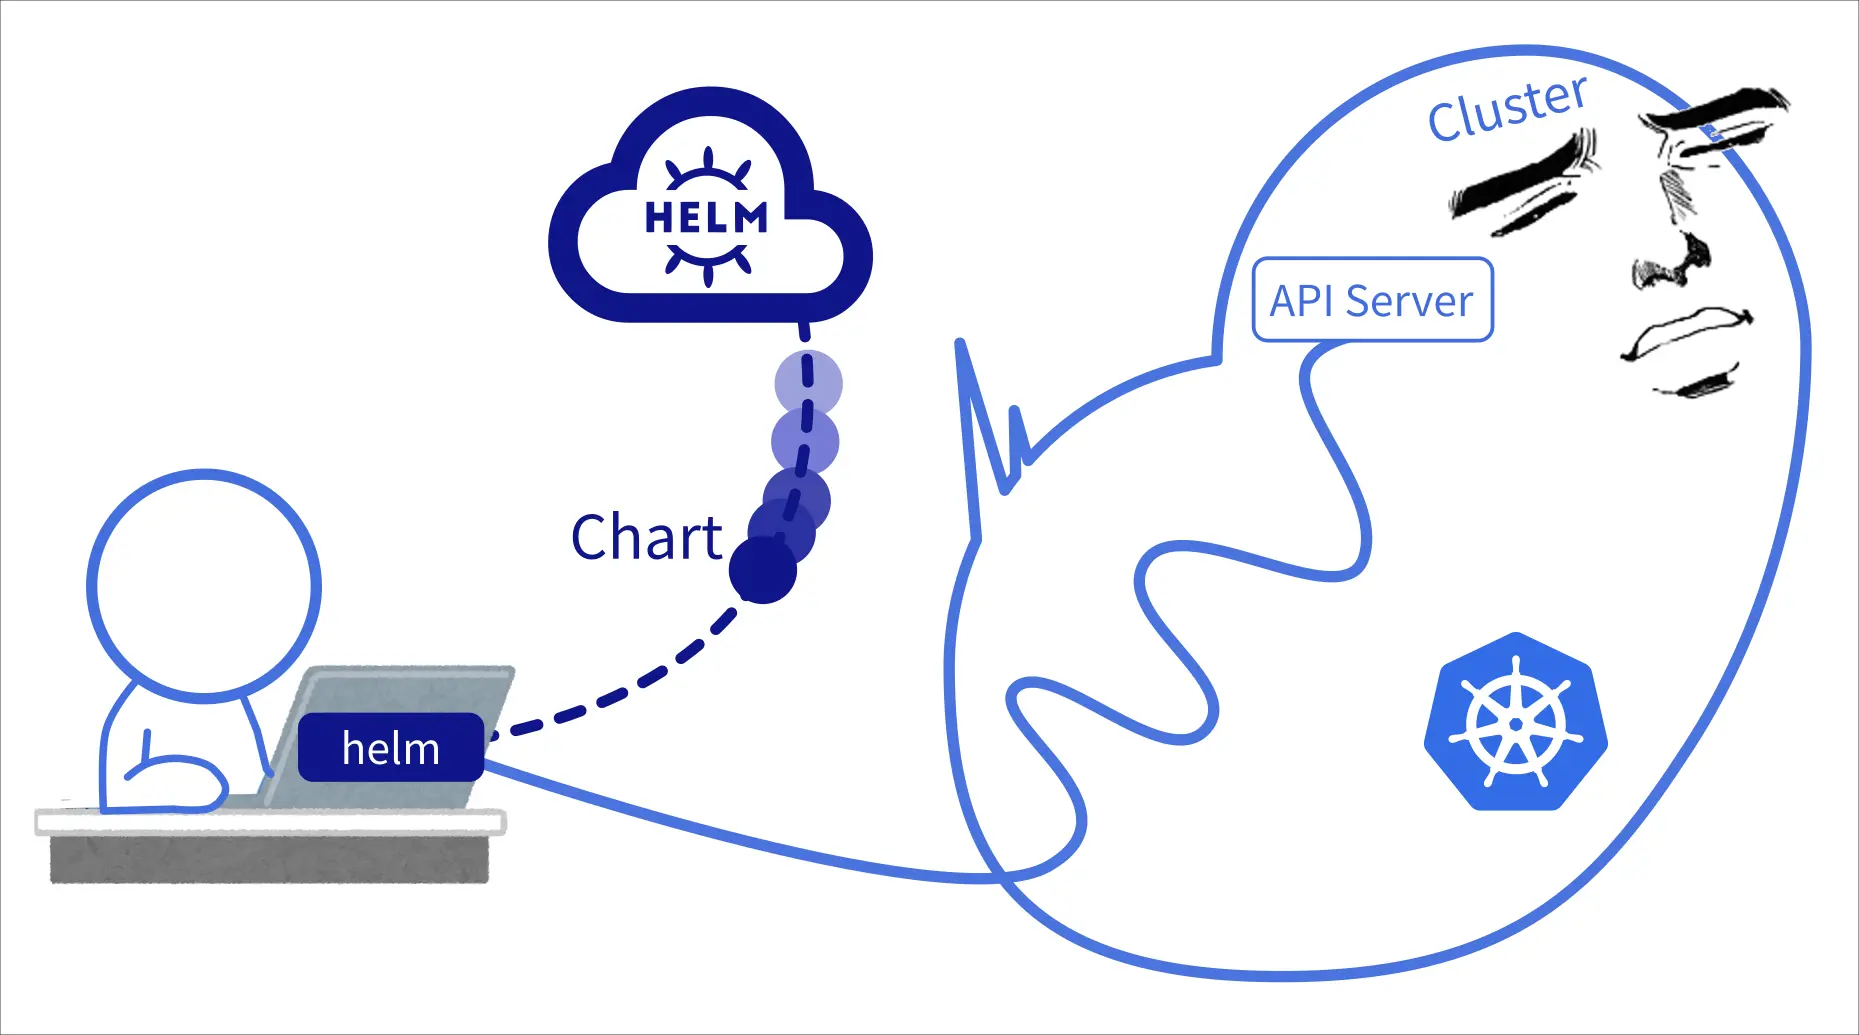
就像 Longhorn 需要四千多行的 YAML 一樣,還有許許多多的雲原生應用軟體實際都是由大量的 K8s 資源或實體交錯編排而成,於是就有了 Helm 這個工具的誕生:一個 K8s 世界的 APT (Advanced Packaging Tool)。

在 Helm 的世界,這一堆聲明的 YAML 被包裝成一個稱作 Chart 的東西,「安裝」(佈署應用程式到 K8s)大概像這樣:

helm repo add longhorn https://charts.longhorn.io
helm repo update
helm install longhorn longhorn/longhorn \
--namespace longhorn-system \
--create-namespace \
--version 1.10.1

Helm 還有另外一個重要的功能:對 Chart 傳入變數,也是今天我要使用 Helm 的主要原因。

用 Helm 安裝 Longhorn​

info

這個段落的內容主要參考 Longhorn 的官方文件1。

首先下載參數檔:

curl -Lo values.yaml https://raw.githubusercontent.com/longhorn/longhorn/refs/tags/v1.10.1/chart/values.yaml

根據需求修改 values.yaml,以我目前的需求為例,分別是:

  • 持久化須儲存到外部 DAS 的掛載點。
  • 目前只有一個工作節點,所以副本只有一份。
defaultSettings:
defaultDataPath: /mnt/das-storage
defaultReplicaCount: 1

安裝 Longhorn 到 K8s:

helm install longhorn longhorn/longhorn \
--namespace longhorn-system \
--create-namespace \
--version 1.10.1 \
--values values.yaml

拉取 Image 需要時間,過程中可以使用指令檢查是不是所有 Pod 已經就位:

$ kubectl -n longhorn-system get pod
NAME READY STATUS RESTARTS AGE
engine-image-ei-3154f3aa-tsq6p 0/1 ContainerCreating 0 23s
longhorn-driver-deployer-58768fb7fd-ktpq8 1/1 Running 0 2m58s
longhorn-manager-bsqms 2/2 Running 2 (44s ago) 2m58s
longhorn-ui-7b9c99fd9-j8bxb 1/1 Running 0 2m58s
longhorn-ui-7b9c99fd9-w2l6b 1/1 Running 0 2m58s

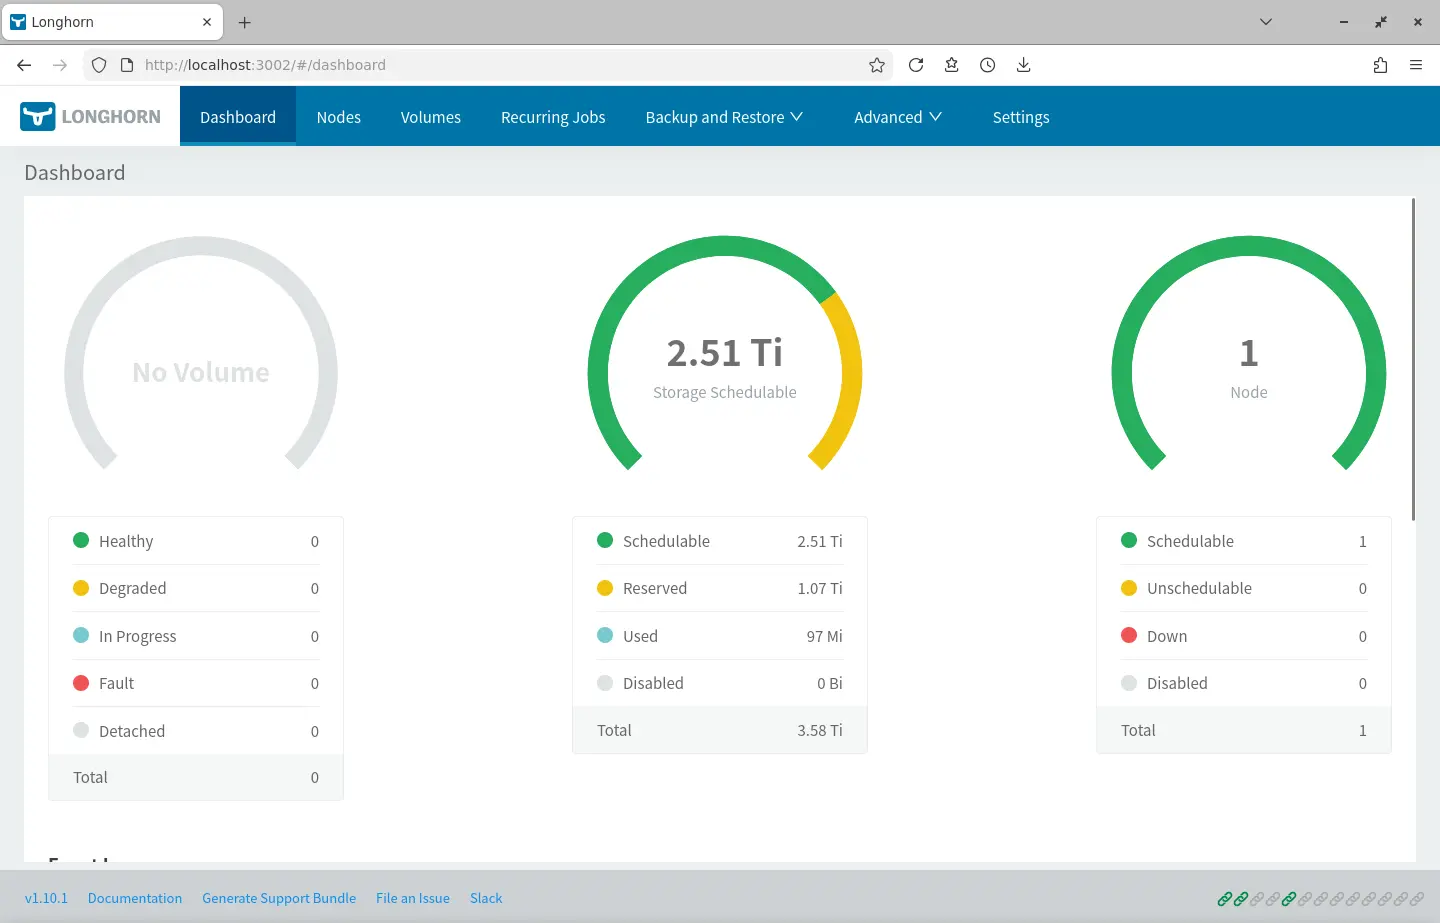
執行 Tunnel 連線到 Longhorn 的 Dashboard2:

kubectl port-forward \
service/longhorn-frontend \
-n longhorn-system 3002:80 \
--address 0.0.0.0

Footnotes​

  1. Longhorn | Documentation. Retrieved 2026-01-05, from https://longhorn.io/docs/1.10.1/advanced-resources/deploy/customizing-default-settings/ ↩

  2. Longhorn 部署筆記 | 翠鳥圖書館 Project Halcyon Library. Retrieved 2026-01-05, from https://wiki.pha.pub/books/109-TAs/page/longhorn ↩

Wei Ji

接續我在前一篇貼文指出的:K8s 本身只是框架,並沒有包含 SDS (Software-defined storage) 的具體實作:

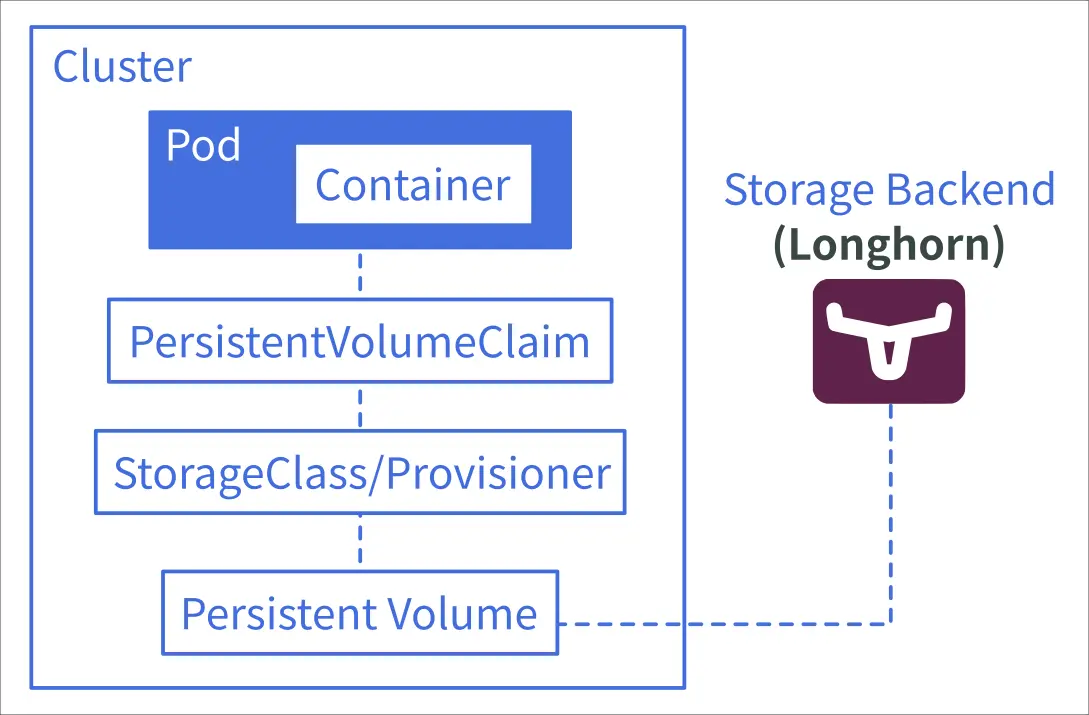
Longhorn 則是其中一種 SDS 實作:

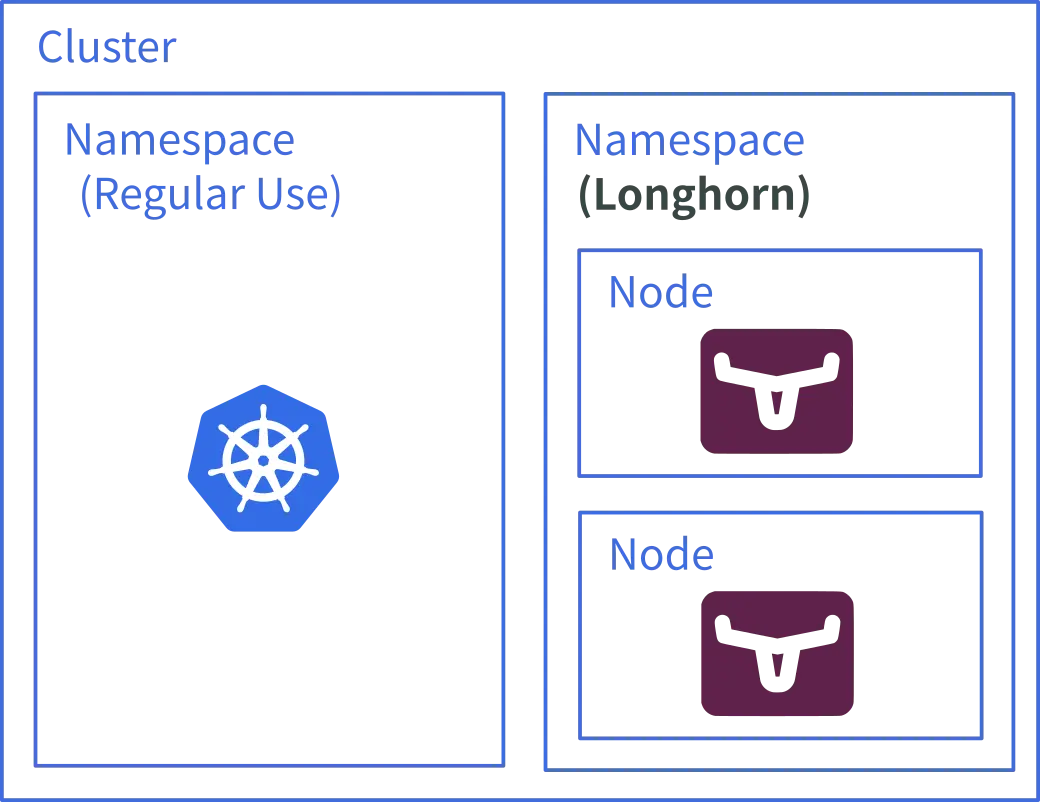
Longhorn 巧妙的運用 K8s 作為基礎設施,將 SDS 運行在 Cluster 內部,並且利用 K8s 的多節點特性運行多個實例,並在多個實例上建立資料冗餘實現分散式副本:

Wei Ji

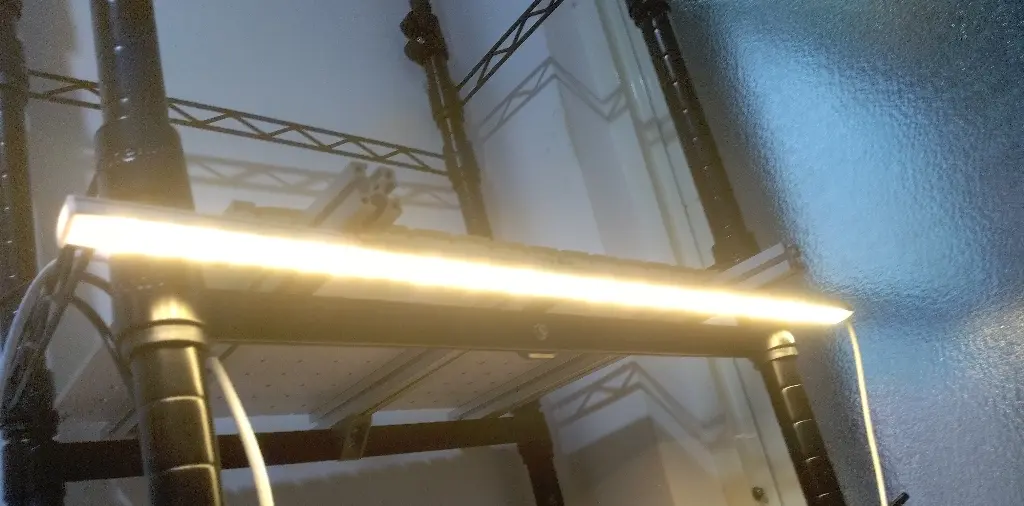
前一陣子跟一個硬體工程師聊天,然後他順便推銷他們公司出的桌面燈,因為是他經手過的產品。老兄,不是我要貶低你的努力,只是我的消費水準是隨便找個鋁擠、幾顆 M4 螺絲、一支 USB 燈條就處理掉桌面照明的人,找我推銷桌面燈是真的找錯人了。

就算真的有興趣想買的,大概也是手術燈那種東西,畢竟在做事的時候光源被手或是頭擋住真的很煩。

Wei Ji

背景​

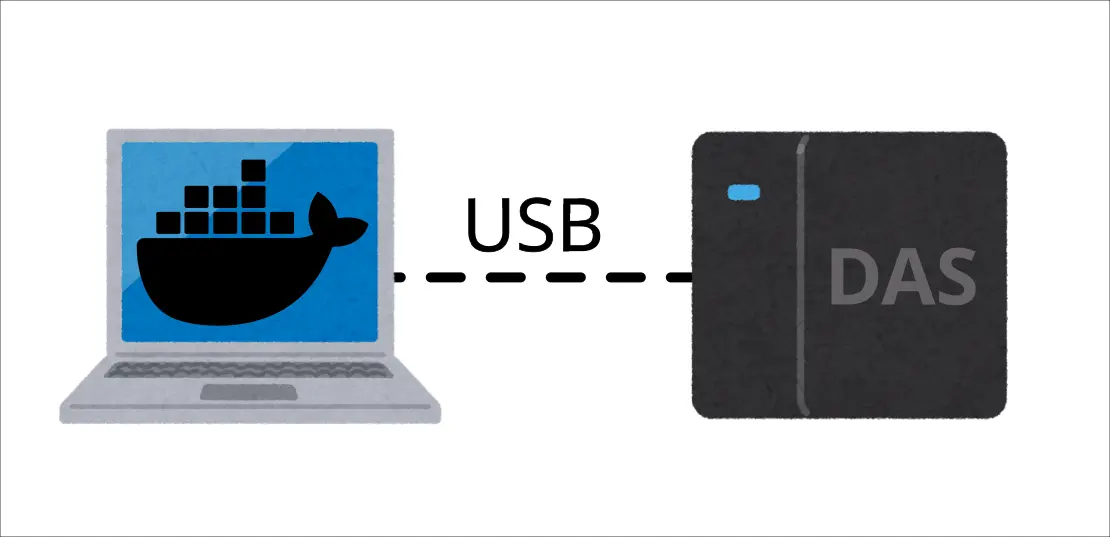
我的 Homelab 是透過筆電和 USB 外接 DAS (Direct Attached Storage) 建構的,並且採過一些小坑。最近在建置新的節點時,發現我把相關的資訊分散在不同的筆記和 IaC (Infrastructure as Code) 裡面,於是想說趁這個機會整理一下資訊。

電池充電上限​

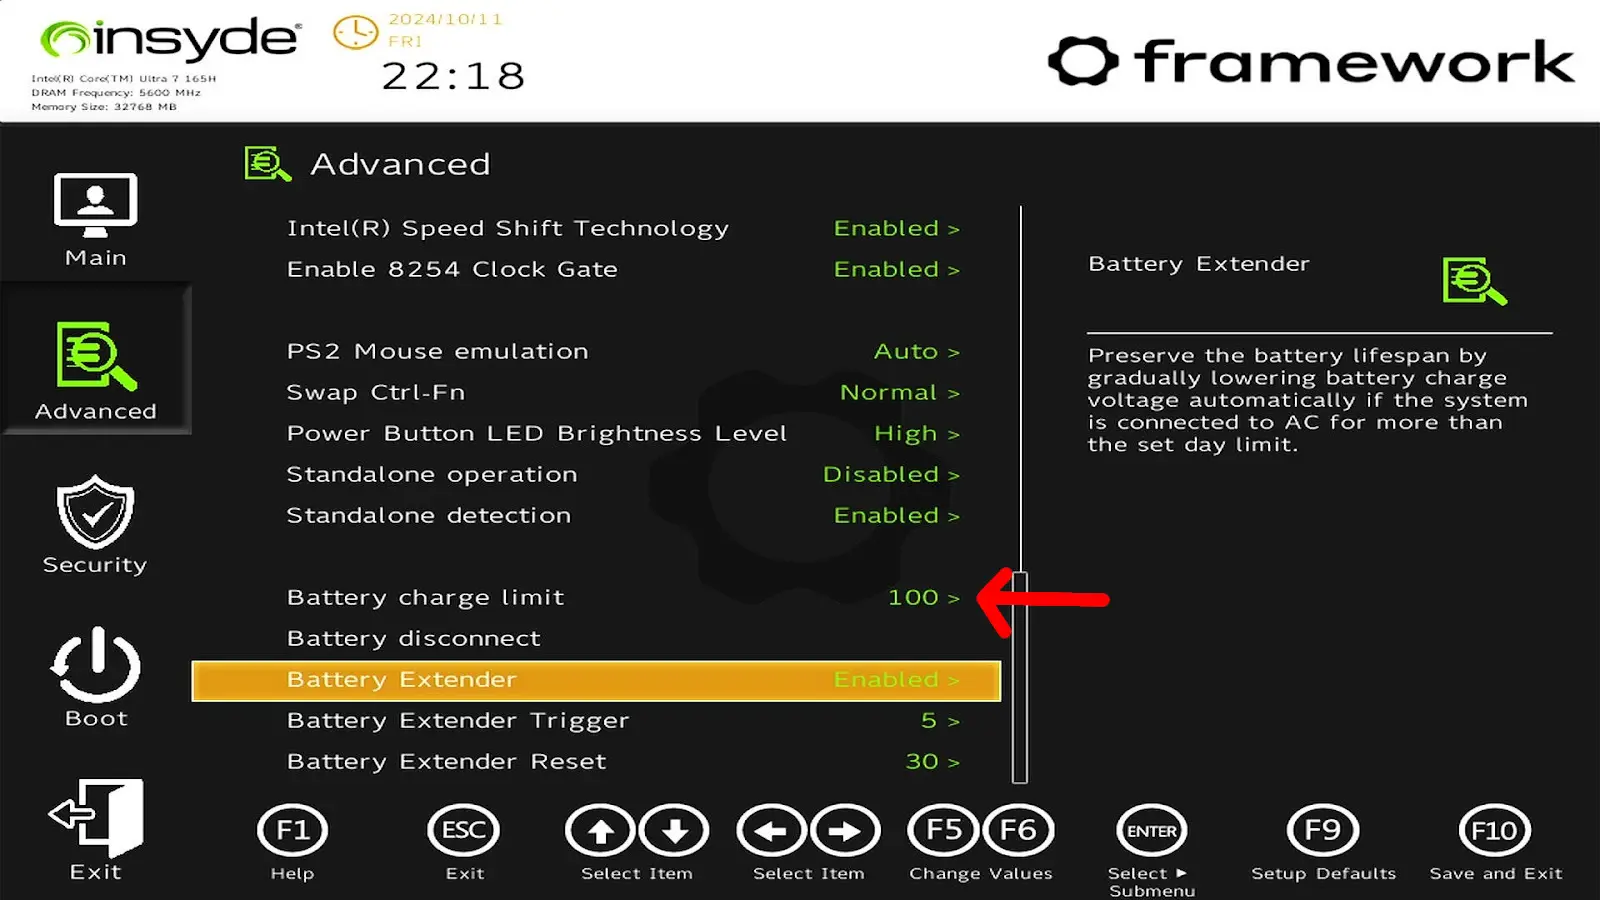
Framework 的話可以在 BIOS 設定充電上限:

(從 Framework 的論壇借用螢幕截圖)

另外一台 Lenovo 的筆電則是靠這個設定:

https://github.com/makifdb/lenopow

我會把把充電上限設在 80% 避免筆電作為伺服器長時間插著充電造成電池膨脹。

筆電螢幕問題​

讓筆電不會因為螢幕蓋上而進入休眠模式,編輯 /etc/systemd/logind.conf:

HandleLidSwitch=ignore

執行指令重啟服務:

systemctl restart systemd-logind.service

但是上述設定會造成另外一個問題:螢幕蓋著還是繼續發光,於是還需要一個步驟,編輯 /etc/default/grub:

在 GRUB_CMDLINE_LINUX_DEFAULT 插入 consoleblank=60。

這會讓螢幕在 60 秒後熄滅。

完整 Ansible Playbook
- name: Setup laptop
hosts:
- arachne-node-beta
tasks:
- name: check if consoleblank is configured in the boot command
ansible.builtin.lineinfile:
backup: true
path: /etc/default/grub
regexp: '^GRUB_CMDLINE_LINUX_DEFAULT=".*consoleblank=60'
state: absent
check_mode: true
register: grub_cmdline_check
changed_when: false
- name: insert consoleblank if missing
ansible.builtin.lineinfile:
backrefs: true
path: /etc/default/grub
regexp: '^(GRUB_CMDLINE_LINUX_DEFAULT=".*)"$'
line: '\1 consoleblank=60"'
when: grub_cmdline_check.found == 0
notify: update grub
- name: Set HandleLidSwitch
ansible.builtin.lineinfile:
backrefs: true
path: /etc/systemd/logind.conf
regexp: "#?(HandleLidSwitch=)(?:.*)$"
line: '\1ignore'
notify: Restart logind
handlers:
- name: update grub
ansible.builtin.command: update-grub
- name: Restart logind
ansible.builtin.systemd_service:
name: systemd-logind
state: restarted

DAS 掛載​

當服務透過 Docker 跑在容器內,持久化資料卻儲存在透過 USB 連線的外部儲存中,這個仰賴關係需要額外處理。

自動化載​

編輯 /etc/fstab 加入以下內容:

# DAS
UUID=7f858b7e-f942-45b3-92dd-8c99b497b6a4 /mnt/das-storage ext4 defaults,nofail,x-systemd.automount 0 2

修改後執行:

systemctl daemon-reload
info

UUID 可以透過 lsblk -f 之類的指令獲得。

設定仰賴​

新增檔案 /etc/systemd/system/docker.service.d/override.conf:

[Unit]
After=mnt-das\\x2dstorage.automount
ConditionPathExists=/mnt/das-storage
systemctl restart docker.service

確保 Docker Daemon 在 DAS 掛載後才運行。

DAS SMART 檢查​

因為電腦沒有直接和硬碟建立連線而是隔著一層 DAS,因此不能使用普通的 smartctl 指令確認,而必須使用額外的參數1:

smartctl -a -d jmb39x-q,0 /dev/sdd
smartctl -a --device jmb39x-q,1 /dev/sdd
smartctl -a -d jmb39x-q,2 /dev/sdd
smartctl -a --device jmb39x-q,3 /dev/sdd

Footnotes​

  1. QNAP External RAID Manager - Export SMART Data - QNAP NAS Community Forum. Retrieved 2026-01-03, from https://forum.qnap.com/viewtopic.php?p=873575&sid=573c6149a1276e4ab8d9f4785f1c6029#p873575 ↩

Wei Ji

安裝​

懶人安裝法:

curl -sfL https://get.k3s.io | sh - 

檢查一下有沒有正常:

sudo k3s kubectl get node 

設定​

從安裝 K3s 的機器複製 /etc/rancher/k3s/k3s.yaml 到想要遠端連線的機器(Client 端)的 ~/.kube/config。1

info

要留意 K8s 的憑證會過期這件事。

Footnotes​

  1. Cluster Access | K3s. Retrieved 2026-01-02, from https://docs.k3s.io/cluster-access ↩

Wei Ji

Pod​

聲明一個 Pod:

apiVersion: v1
kind: Pod
metadata:
name: awesome-pod
labels:
app: awesomeApp
spec:
containers:
- name: awesome-container
image: mendhak/http-https-echo:38
ports:
- containerPort: 8080

根據聲明建立資源(在這個例子中是建立 Pod):

kubectl create -f sample.yaml

接著使用這個指令建立隧道 (tunnel):

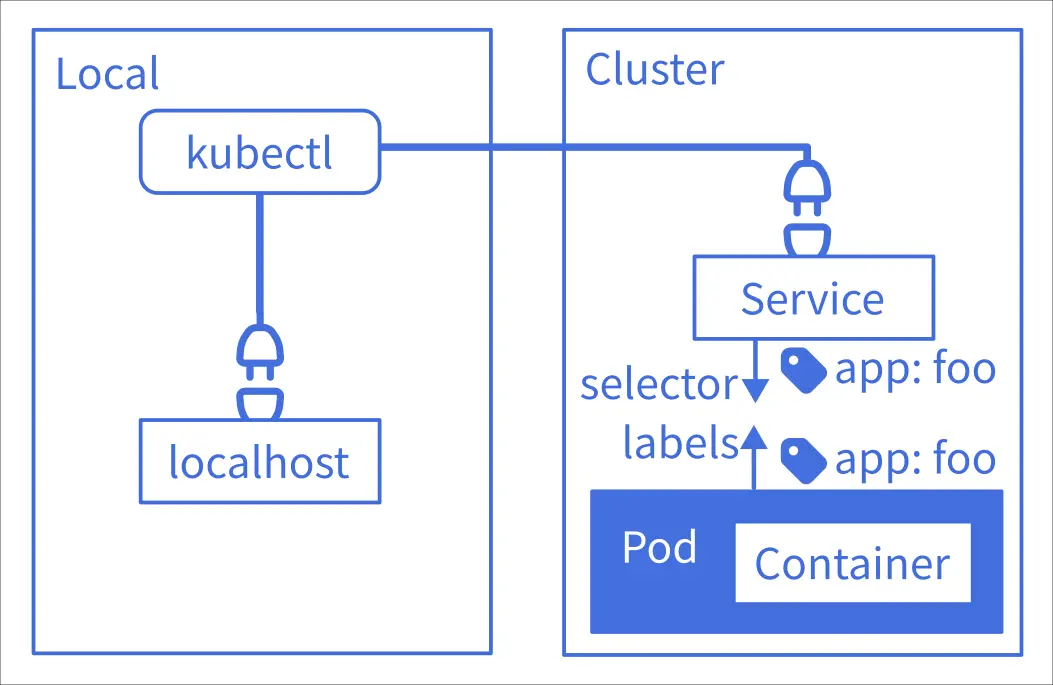
kubectl port-forward awesome-pod 3001:8080

接著就可以透過這個連結訪問剛剛建立的 Pod 了: http://localhost:3001

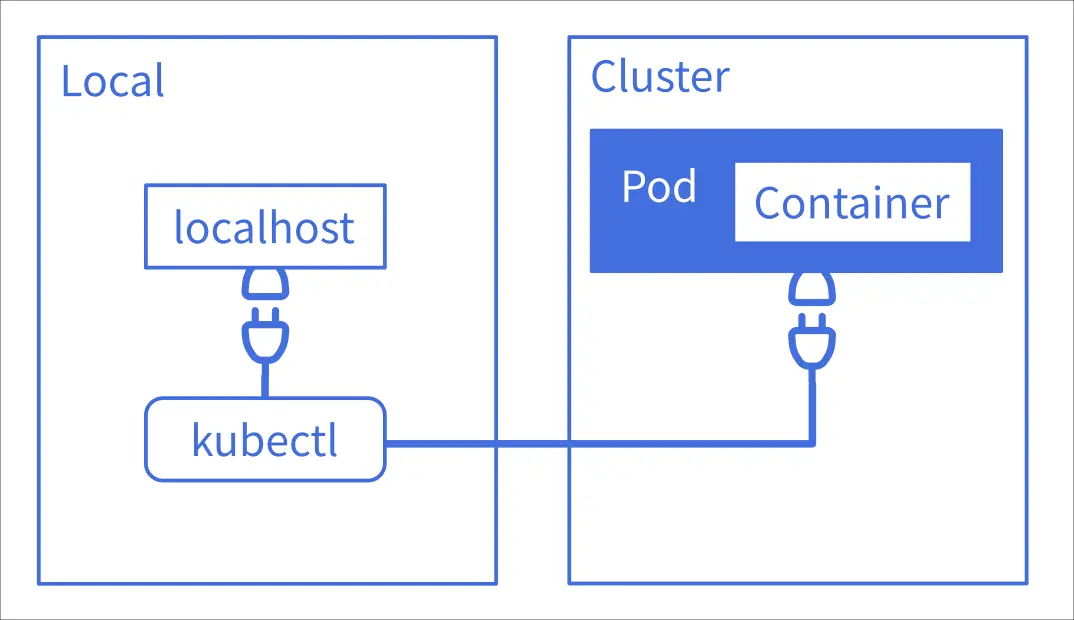
這個通道是臨時的,中止指令就會消滅通道,使用過 ngrok 的人或許會對這種感覺不陌生,它就像是「反向的 ngrok」,暫時將 Cluster 內特定的資源暴露到本機上。

info

玩耍結束後不要忘記銷毀資源:

kubectl delete -f sample.yaml

Service​

Pod 在 K8s 的世界裡其實是雜魚、消耗品,可能會故障然後被清除掉之後被新建的 Pod 取代,又或是為了負載需求而被複製成一堆一樣參數的 Pod,Pod 的 IP 也因此是浮動的,實際使用你不會直接連線到特定的 Pod,而是透過一層抽象找到「在運行這種服務的 Pod」,那個抽象就是 Service。這個抽象不只是用於外部訪問,也包含 Pod 對 Pod 的內部連線。

ClusterIP​

一個 Service 大概長得像這樣:

apiVersion: v1
kind: Service
metadata:
name: awesome-service
spec:
selector:
app: awesomeApp
type: ClusterIP
ports:
- protocol: TCP
port: 3001
targetPort: 8080
完整的檔案如下: sample.yaml
apiVersion: v1
kind: Pod
metadata:
name: awesome-pod
labels:
app: awesomeApp
spec:
containers:
- name: awesome-container
image: mendhak/http-https-echo:38
ports:
- containerPort: 8080
---
apiVersion: v1
kind: Service
metadata:
name: awesome-service
spec:
selector:
app: awesomeApp
type: ClusterIP
ports:
- protocol: TCP
port: 3001
targetPort: 8080
# 用一樣的指令把服務帶起來:
kubectl create -f sample.yaml

# 開 tunnel
kubectl port-forward service/awesome-service 3002:3001

只是這次我們連線的目標不是 Pod 而是 Service: http://localhost:3002

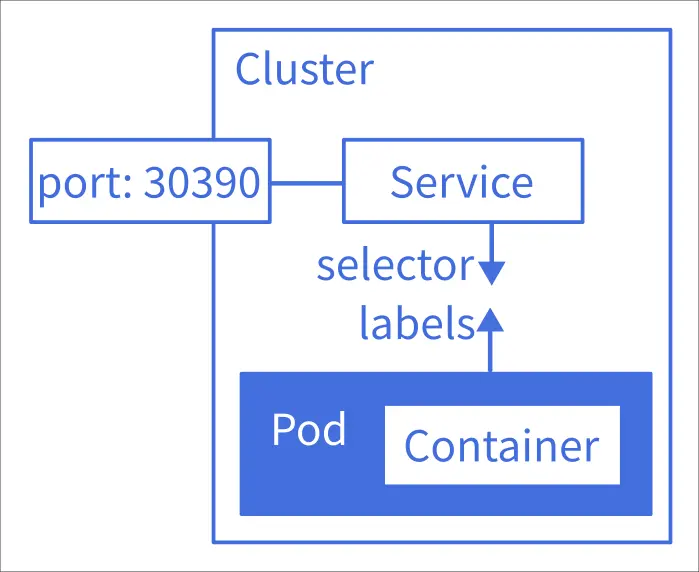
ClusterIP 尚未真正對外暴露我們的服務,這個模式主要給 Pod 內部訪問用(路徑3→2)1:

NodePort​

apiVersion: v1
kind: Pod
metadata:
name: awesome-pod
labels:
app: awesomeApp
spec:
containers:
- name: awesome-container
image: mendhak/http-https-echo:38
ports:
- containerPort: 8080
---
apiVersion: v1
kind: Service
metadata:
name: awesome-service
spec:
selector:
app: awesomeApp
type: NodePort
ports:
- protocol: TCP
port: 3001
targetPort: 8080
nodePort: 30390

接著用一樣的指令把服務帶起來:

kubectl create -f sample.yaml

這次從 Node 的 IP 訪問(例如: http://192.168.0.123:30390)

info

Service 除了 ClusterIP 和 NodePort 以外,還有其他種類,不過在此不做過多的解釋,因為不是本文重點。

Deployment​

Pod 在 K8s 的世界裡其實是雜魚、消耗品

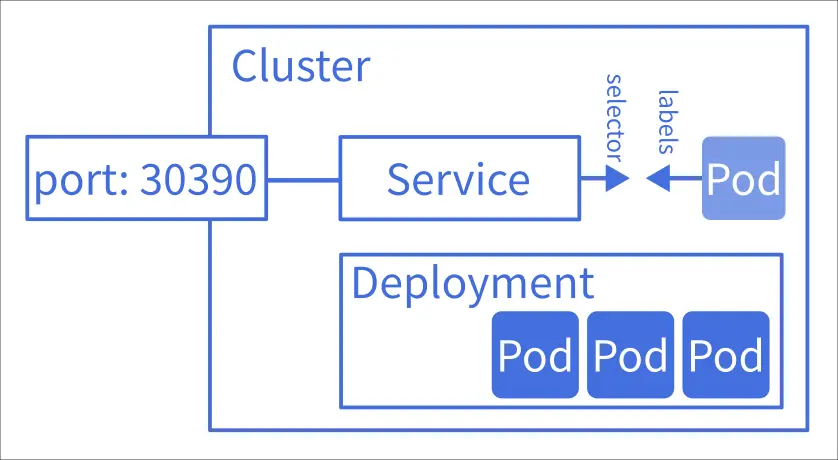
是的,在 K8s 我們一般不會直接佈署 Pod,而是透過 Deployment 組件(或是其他類似功能的組件)來間接的佈署 Pod:

apiVersion: apps/v1
kind: Deployment
metadata:
name: awesome-deployment
spec:
replicas: 3
template:
metadata:
labels:
app: awesomeApp
spec:
containers:
- name: kubernetes-demo-container
image: mendhak/http-https-echo:38
ports:
- containerPort: 8080
selector:
matchLabels:
app: awesomeApp
---
apiVersion: v1
kind: Service
metadata:
name: awesome-service
spec:
selector:
app: awesomeApp
type: NodePort
ports:
- protocol: TCP
port: 3001
targetPort: 8080
nodePort: 30390

你可以用瀏覽器打開它(例如: http://192.168.0.123:30390), 不過你可能只會看到相同的 os.hostname,試試多執行幾次 curl:

curl http://192.168.0.123:30390/ | jq .os.hostname

Footnotes​

  1. Kubernetes Service 概念詳解 | Kubernetes. Retrieved 2026-01-01, from https://tachingchen.com/tw/blog/kubernetes-service/ ↩

Wei Ji

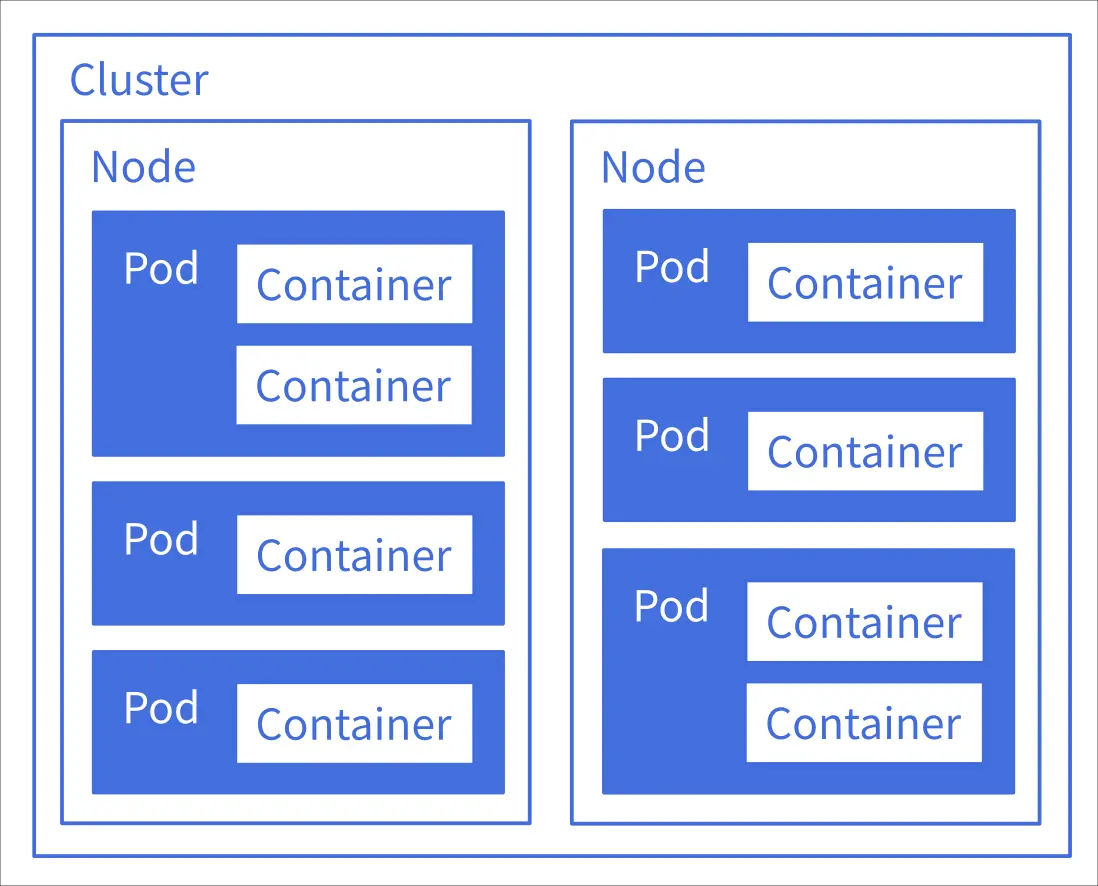
  • Node
    • 一個安裝 K8s 的實體機器或虛擬機器。
  • Cluster
    • 多個 Node 構成的叢集。
  • Pod
    • K8s 的最小佈署單位。
    • 通常包含一個 Container。
    • 視情況可以包含多個 Container。
  • Container
    • OCI (Open Container Initiative) 容器。

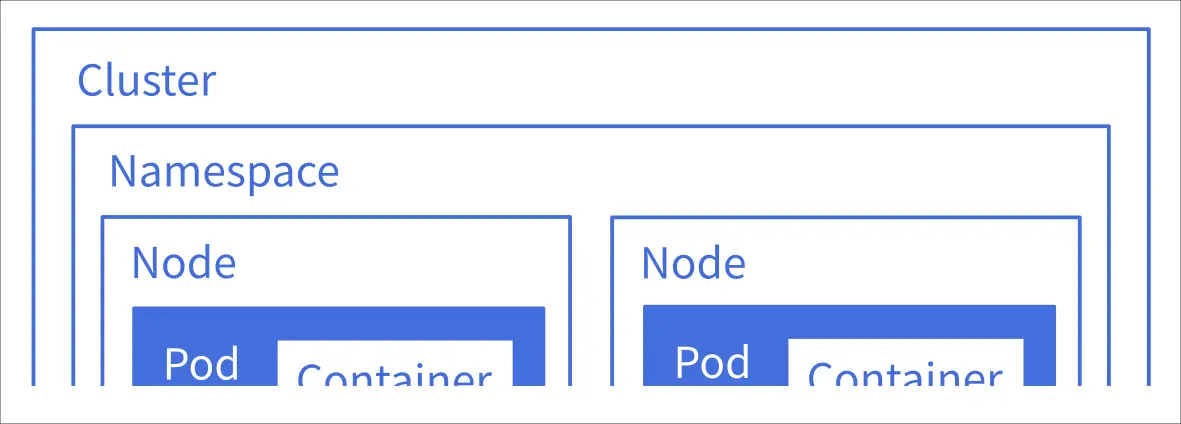
Namespace​

在同一個 Cluster 下可以再設定一個 Namespace 來隔離資源,知道有這個東西就好,初學者可以先不管它的存在。

Wei Ji

作為一個網頁前端導向的開發者,接觸 Systemd 的角度較資深一輩的工程師(或正規 CS (Computer Science) 路線出生的人)不太一樣,當前輩們已經在進行「Systemd 大一統」跟「No Systemd」之間的宗教戰爭的時候,我才在 Docker 容器內接觸內接觸第一個行程的問題 (PID 1 Problem)。

這裡紀錄並整理一下自己在這條路上的一些經歷和觀察。

info

正確的術語應該是 OCI (Open Container Initiative) 容器,不過為了方便溝通本文會視情況使用俗稱的 Docker。另一方面,筆者在學習過程確實是先使用 Docker,使用 Docker 以外的 Runtime 其實也只是不久之前的事。

Dockerfile 中的 ENTRYPOINT 與 CMD​

實際上 ENTRYPOINT 才決定了第一個行程 (Process) 是誰,CMD 只是後面被帶進去的參數。

有沒有經歷過 docker compose down 但是某個服務 (service) 卻遲遲沒有被關閉,整個過程停頓了一會兒才把整套服務簇釋放掉?

這十之八九是因為 ENTRYPOINT 沒有處理 SIGTERM 的能力造成的,開發環境或許不打緊,但是在生產環境如果有請求 (request) 掛著還沒處理完,然而容器被更新強制關閉的話,帶來的問題是十分致命的。

容器編排 (Container Orchestration)​

在 Docker Compose 允許用 YAML 將多個容器組織起來構成服務簇,並且使用 depends_on 來設定仰賴關係並控制容器的啟動順序、restart 來設定重啟策略、healthcheck 判斷容器狀態。

info

一個 service 其實可以設定多個容器(透過 replicas 或是 scale),不過為了簡化描述我在上面並沒有直接指出。

多個 Process 的容器​

info

以下不少經驗來自工作上面對的問題,專案細節就不透漏了。

第一次遇到這樣的需求來自業務上的要求:

將調用 SideFX Houdini 的 Python 伺服器容器化

它要求運行一個授權伺服器 (License Server),透過 Python 載入的 SDK 和這個伺服器之間會定時檢查彼此的存在。當時簡單使用 entrypoint.sh 、& 語法和 sleep 把兩個行程跑了起來。


後來遇到另外一個需要解決的問題:

LibreOffice 作為一個無頭 (headless) 伺服器運作。 Python 程式使用 UNO (Universal Network Objects) 界面與之溝通。 佈署在單一容器的 Serverless 雲環境,因此只能有一個容器。

這次我使用了 Supervisor 來解決問題1。


接下來的案例是真正讓我將 「Docker 內的 PID 1 問題」與「主機上的 PID 1 問題」連在一起的關鍵:LinuxServer.io。

Blender 是一個面向 3D 設計師的軟體,它是 Maya 或 3ds Max 這類軟體的開源競爭者。LinuxServer.io 使用了某種黑魔法允許 Blender 被運行在容器內,使用者則透過去網頁瀏覽器與之互動,並且 Blender 並不是唯一被這樣操作的軟體,除此之外 LinuxServer.io 還封裝了各種 GUI 軟體到 Dokcer 容器內。

LinuxServer.io 使用已經存在的實作 (KasmVNC) 來達成這些目標,不過魔法的關鍵在於:

使用 s6-overlay 運行與管理包含 X Server 在內的多個程式。

s6-overlay 不只能夠啟動多個程式,還能聲明程式與程式之間的仰賴關係,來依序啟動,甚至區分了「執行一次」和「持續在背景運作」的程式。

info

因為不是本文重點,所以我沒有細談整個過程,大致上就是根據那個 Blender 容器的文件與原始碼找到實作的方式,留下 repo 供參考:

嵌入式 Linux 中的 /etc/init.d/rcS​

我曾經在嵌入式 Linux 看到這樣的東西:

$ ls /etc/init.d
rcK rcS S01syslogd S02klogd S02sysctl

當時我也根據需求寫了一個簡單的 S03sdmnt 腳本來掛載 SD 卡。

後來才知道這是根據 System V Init 簡化後的設計。

info

完整的故事跟細節我有寫另外一篇文章描述:

https://flyskypie.github.io/blog/2022-12-03_3ds_linux_javascript_bad_apple/

Systemd 口味的容器編排軟體​

Quadlet 是我試著轉向使用 Podman 得知的東西,雖然最後我並沒有用過就了,而是使用 Podman Compose,省得還要另外維護一份語法不一樣的東西。

下面是 Quadlet 聲明一個服務的例子2:

[Unit]
Description=A minimal container

[Container]
# Use the centos image
Image=quay.io/centos/centos:latest

# In the container we just run sleep
Exec=sleep 60

[Service]
# Restart service when sleep finishes
Restart=always

[Install]
# Start by default on boot
WantedBy=multi-user.target default.target

從領域驅動(Domain-driven)的角度來看這件事​

不難發現上述不同的工具都在解決幾個類似的問題:

  • 系統初始化(啟動與關機),如:掛起背景程式。
  • 根據背景程式的仰賴關係依序掛起,如:應用程式仰賴資料庫。
  • 處理背景程式的異常狀態,如:崩潰重啟。

這些問題構成的問題領域 (Problem Domain) 可以被定位為系統初始化 (System Init) 和行程管理 (Process Supervision)。

而上述工具則是這個 Problem Domain 對應的解決方案領域 (Solution Domain)。

Systemd 則是這個 Solution Domain 中最有名的工具之一。

Footnotes​

  1. 使用 Supervisor 來管理程式 | 《Docker —— 從入門到實踐》正體中文版. Retrieved 2025-12-29, from https://philipzheng.gitbook.io/docker_practice/cases/supervisor ↩

  2. 在 Podman 管理多個 container • 鰭狀漏斗. Retrieved 2025-12-29, from https://vrabe.tw/blog/manage-multi-containers-in-podman/ ↩

Wei Ji

最近想學 K8s 然後陸續把 Homelab 的服務從 Docker Swarm 移過去,不過一直靜不下心好好讀它,思緒糊成一團,於是想說先把一些已經知道的事情整理一下。

動機​

info

因為我實際上還未實際使用 K8s,所以以下可以當成「對 K8s 的美好幻想」。

簡單紀錄一下幾個讓我想學 K8s 的動機。

Image Volume​

前一陣子在鼓搗 Keyclaok,並且外掛了兩個組件:

Keycloak 的插件機制是將 *.jar 檔案放到 /opt/keycloak/providers/ 下,待啟動時被載入。

在 OCI (Open Container Initiative) 佈署下處理這種這整合有兩種方法:

  • 建置階段:直接在 Dockerfile 用 COPY 完成組裝。
  • 佈署階段:透過 Volume 將 jar 檔案掛載進容器。

前者缺乏彈性;後者 Docker 不支援,但是 K8s 支援1。

info

話說回來這幾天在讀 Docker Compose 的 spec 看到這東西(image):

// service.volumes.type
"type": {
"type": "string",
"enum": ["bind", "volume", "tmpfs", "cluster", "npipe", "image"],
"description": "The mount type: bind for mounting host directories, volume for named volumes, tmpfs for temporary filesystems, cluster for cluster volumes, npipe for named pipes, or image for mounting from an image."
},

也許 Docker 也支援了說不定。

depends_on​

Docker Compose 使用 depends_on 來延遲一些容器的啟動,避免仰賴其他容器的服務過早的啟動,例如:後端嘗試對還沒準備完成的資料庫進行連線。

Docker Swarm 則不支援這個功能,它的邏輯是透過 health check:反正有仰賴的容器連線失敗會 health check 失敗,直接重啟容器直到成功為止。但是這樣的設計無法運行相對複雜的服務,例如:我嘗試在 Swarm 模式下運行 GVM (OpenVas) 並沒有成功過。

而 K8s 則是透過 initContainers 的機制來處理這類需求。

Serverless​

工作時使用雲端的 Serverless 的服務 (GCP Cloud Run),因此我對於自架 (selfhosted) 方案很感興趣,也有找到一些開源方案,不過它們多基於 K8s,例如:

info

我這裡是指基於 OCI 的 Serverless,非 OCI 的 "Function based" Serverless 方案通常都有緊支援特定程式語言的限制。

K3s 與遠端訪問​

前幾天 (2025-12-23) 安裝完 K3s 設定遠端訪問時看到這個:

$ kubectl config view
apiVersion: v1
clusters:
- cluster:
certificate-authority-data: DATA+OMITTED
server: https://127.0.0.1:6443
name: default
contexts:
- context:
cluster: default
user: default
name: default
current-context: default
kind: Config
preferences: {}
users:
- name: default
user:
client-certificate-data: DATA+OMITTED
client-key-data: DATA+OMITTED

雖然知道 certificate-authority-data 大概是為了 HTTPS 的加密機制而準備的,不過我其實不知所以然。

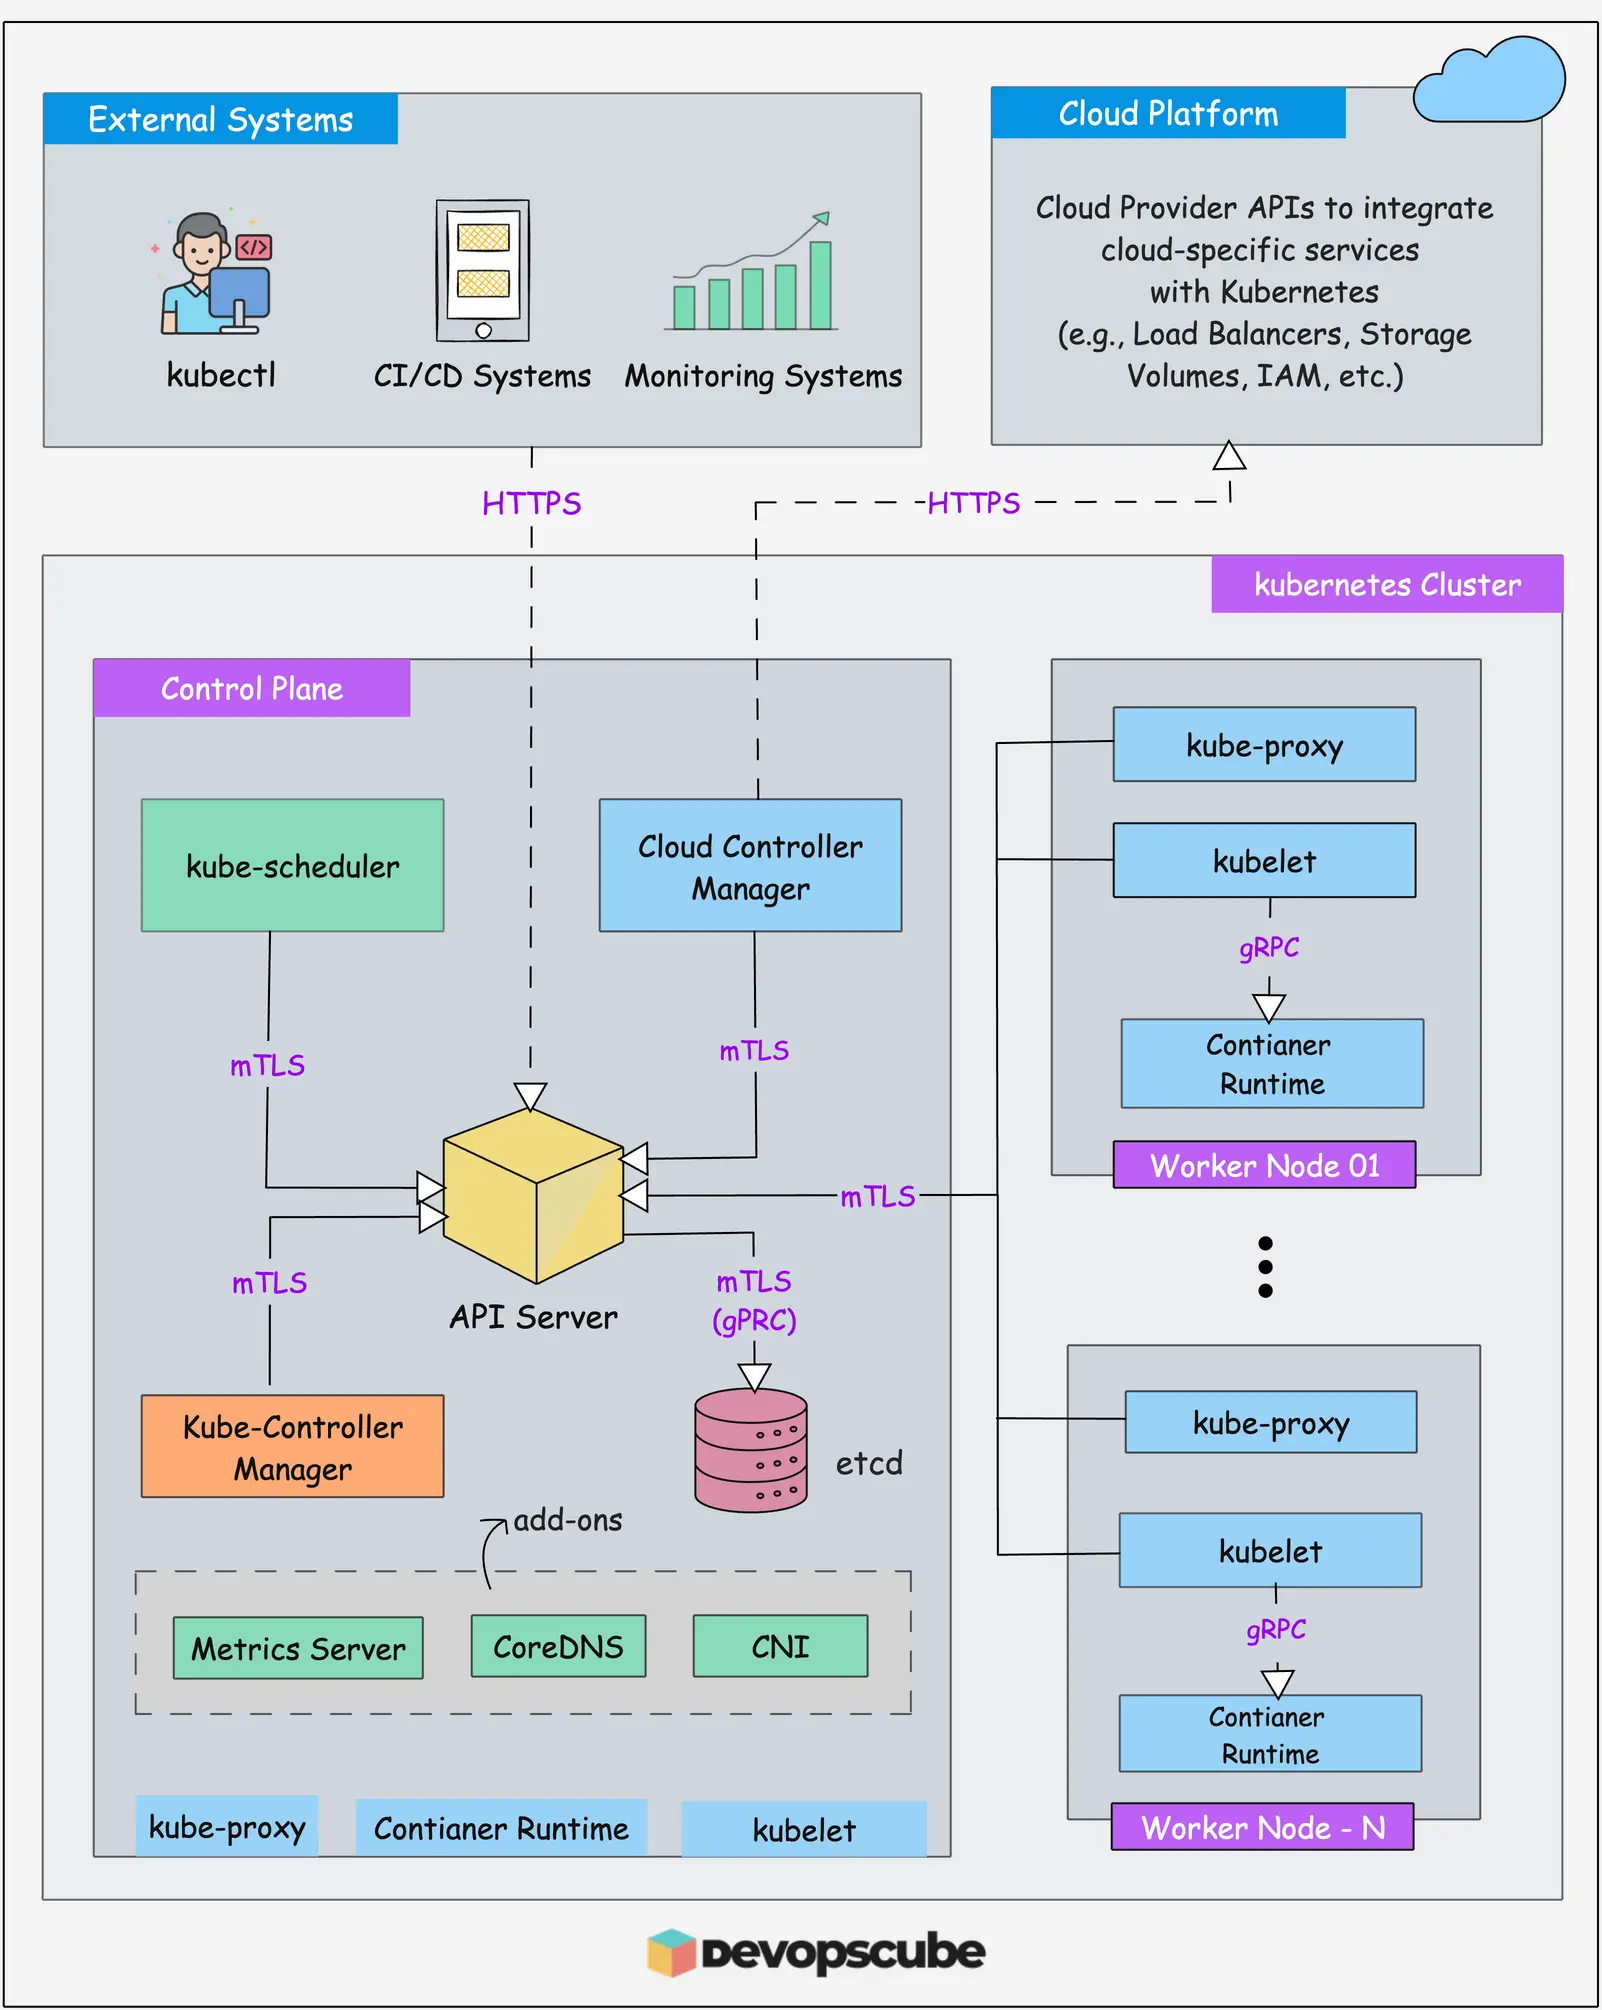
K8s 架構圖​

查資料的時候看到這張架構圖:

我注意到 K8s 的組件之間通訊都是加密的,這讓我想到之前透過「Kubernetes The Hard Way」學習 K8s 的經驗。

以及某篇文章,有個老兄抱怨 K8s 難用,伺服器癱瘓的原因似乎是憑證過期,並且它們最後在 AWS 找到了歸屬。

Kubernetes The Hard Way​

Kubernetes The Hard Way 是一個架設 K8s 的教學,但是不使用現成的安裝精靈,而是手動安裝與配置每一個組件。

去年(2024 年 1 月)我其實試著依照這份指南的步驟嘗試在一台 x86 32 位元筆電上建立 K8s,雖然最後沒有持續下去,但是我隱約記得過程中一直在生成金鑰跟簽署憑證。

info

我當時有試著將執行過得步驟寫成 Make/Ansible 腳本:

https://github.com/FlySkyPie/k8s-builder-and-installer-for-x86-single-node

正確打開 K8s 的方式...難道是密碼學?​

作為一個以開發前端業務邏輯為重心的開發者,密碼學相關的基礎概念可以說是很容易被輕忽的部份。或許我該好好的梳理以下對於加密技術的基礎概念作為。

當然,如果我只是要作為 K8s 的使用者,這些知識似乎沒有這麼重要,不過我同時還是要在 Homelab 架設 K8s 的維護者,我不認為紮紮時時的把基礎打好有什麼壞處。

Footnotes​

  1. Use an Image Volume With a Pod | Kubernetes. https://kubernetes.io/docs/tasks/configure-pod-container/image-volumes/ ↩